I Want AI Now
한국시간 2026년 9월 16일 새벽 3시 17분. X(옛 트위터)에 이런 글이 올라왔다.
"ChatGPT를 공동 발명한 뒤, 나는 계속 자문했다. 초인적인 채팅 모델은 왜 AGI로 이어지지 않았을까? 지난 2년간 스텔스로 모델을 훈련하는 새로운 방법(RLCD)과 새로운 종류의 프런티어 AI 모델을 만들었고, 오늘 그 모델 Jev를 공개한다."
그 아래엔 처리 속도가 20~200배 빠르고 비용은 40~400배 싸다는 숫자가 붙었다. 글쓴이는 디오고 알메이다. OpenAI에서 ChatGPT의 토대가 된 InstructGPT 논문에 이름을 올린 연구자다. 이날 그가 세운 TypeSafe AI가 스텔스를 벗었다. 보도자료에 따르면 회사는 2024년 설립됐고 본사는 샌프란시스코에 있으며, 벤처캐피털 DCVC가 주도한 4,000만 달러 시드 투자를 받았다.
반응은 빨랐다. 한 시간 남짓 뒤 해커뉴스에 올라온 발표문은 16일 밤 1,500점을 넘겼고 댓글은 430개를 넘었다. 14일 저녁부터 16일 저녁까지 48시간 동안 해커뉴스에 올라온 글 가운데 두 번째로 높은 점수였고, AI 관련 글로는 가장 높았다. 국내에선 아침 8시 무렵부터 디시인사이드 '특이점이 온다' 갤러리에 관련 글이 이어졌다. 16일 새벽 1시 46분부터 밤 9시 44분 사이 이 갤러리에 올라온 글 1,435건 가운데 81건의 제목이 Jev 관련 검색어에 걸렸다. 개념글에 오른 한 게시물 "니들 jev는 보고 갤질하냐???"에는 2분도 안 돼 두 갈래 댓글이 붙었다. "환각0퍼라던데 신기하다요." 그리고 "환각이 아니고 json 형식 맞추는거 아냐?"
이번 논쟁의 핵심이 이 두 댓글 사이에 있다. Jev에서 무엇이 새롭고, 무엇이 광고 문구인가. 이 글은 TypeSafe가 직접 공개한 블로그와 기술 문서, 평가 사이트의 원자료를 대조해 그 경계를 긋는다.
⚖️ 먼저 밝혀 둘 이해관계 — Jev의 비교 대상에는 앤트로픽의 Claude 모델(Opus 5·Sonnet 5·Haiku 4.5)이 들어 있고, 채점 기준이 된 답에도 앤트로픽의 Fable 5.1이 쓰였다. 이 글의 자료 정리와 초안 작성에는 앤트로픽이 만든 모델이 참여했다. 그래서 수치는 TypeSafe 평가 사이트의 표기값을 그대로 옮기고, 편집부가 계산한 값은 계산이라고 밝혔다. 영문 인용은 편집부 번역이다.
한 줄 결론 — Jev는 자유로운 문장 대신, 미리 정해 둔 질문에 구조화된 판단과 확률을 돌려주는 모델이다. '444.6배 저렴'과 '환각 0%'는 조건을 알고 읽어야 하는 숫자지만, 사람이 코드로 짜거나 직접 판단하던 분기를 싸고 빠른 AI 판단으로 채우겠다는 방향은 AI 자동화를 고민하는 사람이라면 눈여겨볼 만하다.
Jev는 문장 대신 '체크 표시'를 돌려준다
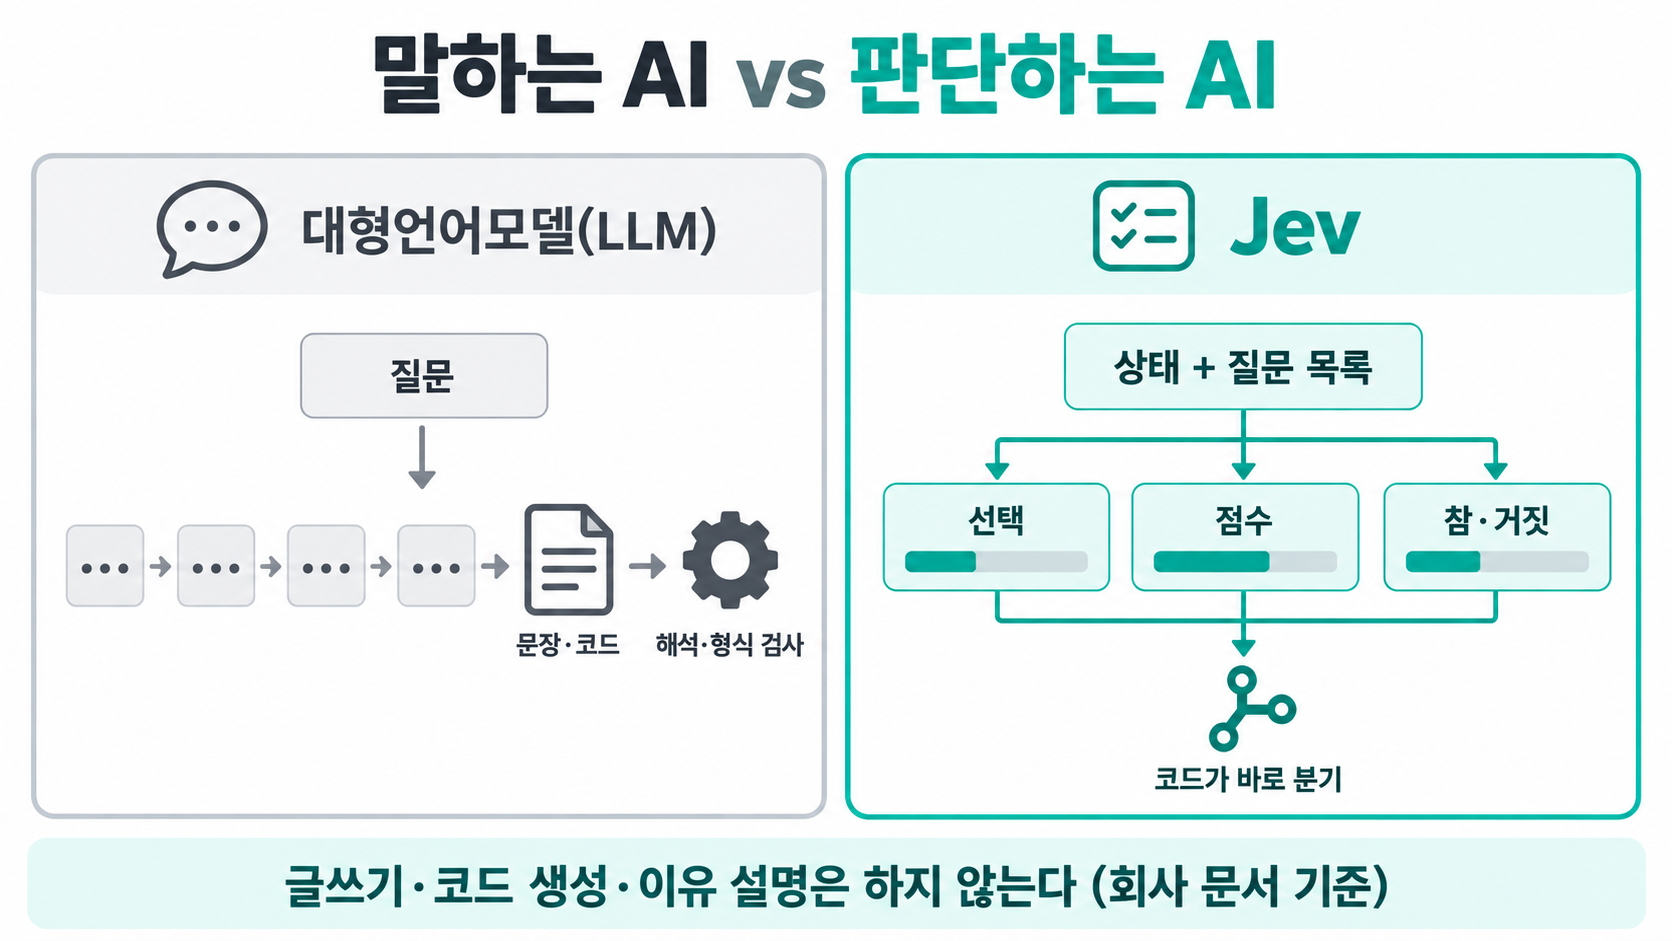
ChatGPT 같은 대형언어모델(LLM)은 글자 조각(토큰)을 하나씩 이어 붙여 답을 만든다. 편지도 쓰고 코드도 짜는 만능의 비결이다. 하지만 프로그램이 그 답을 받아 쓰려면 문장을 해석하고 형식을 검사하는 단계가 필요하다. LLM에도 JSON 같은 형식을 강제하는 '구조화 출력' 기능이 있지만, TypeSafe는 홈페이지 FAQ에서 LLM을 형식에 끼워 맞추면 지능 일부를 잃을 수 있다며 Jev는 처음부터 구조화된 판단용으로 학습했다고 설명한다.
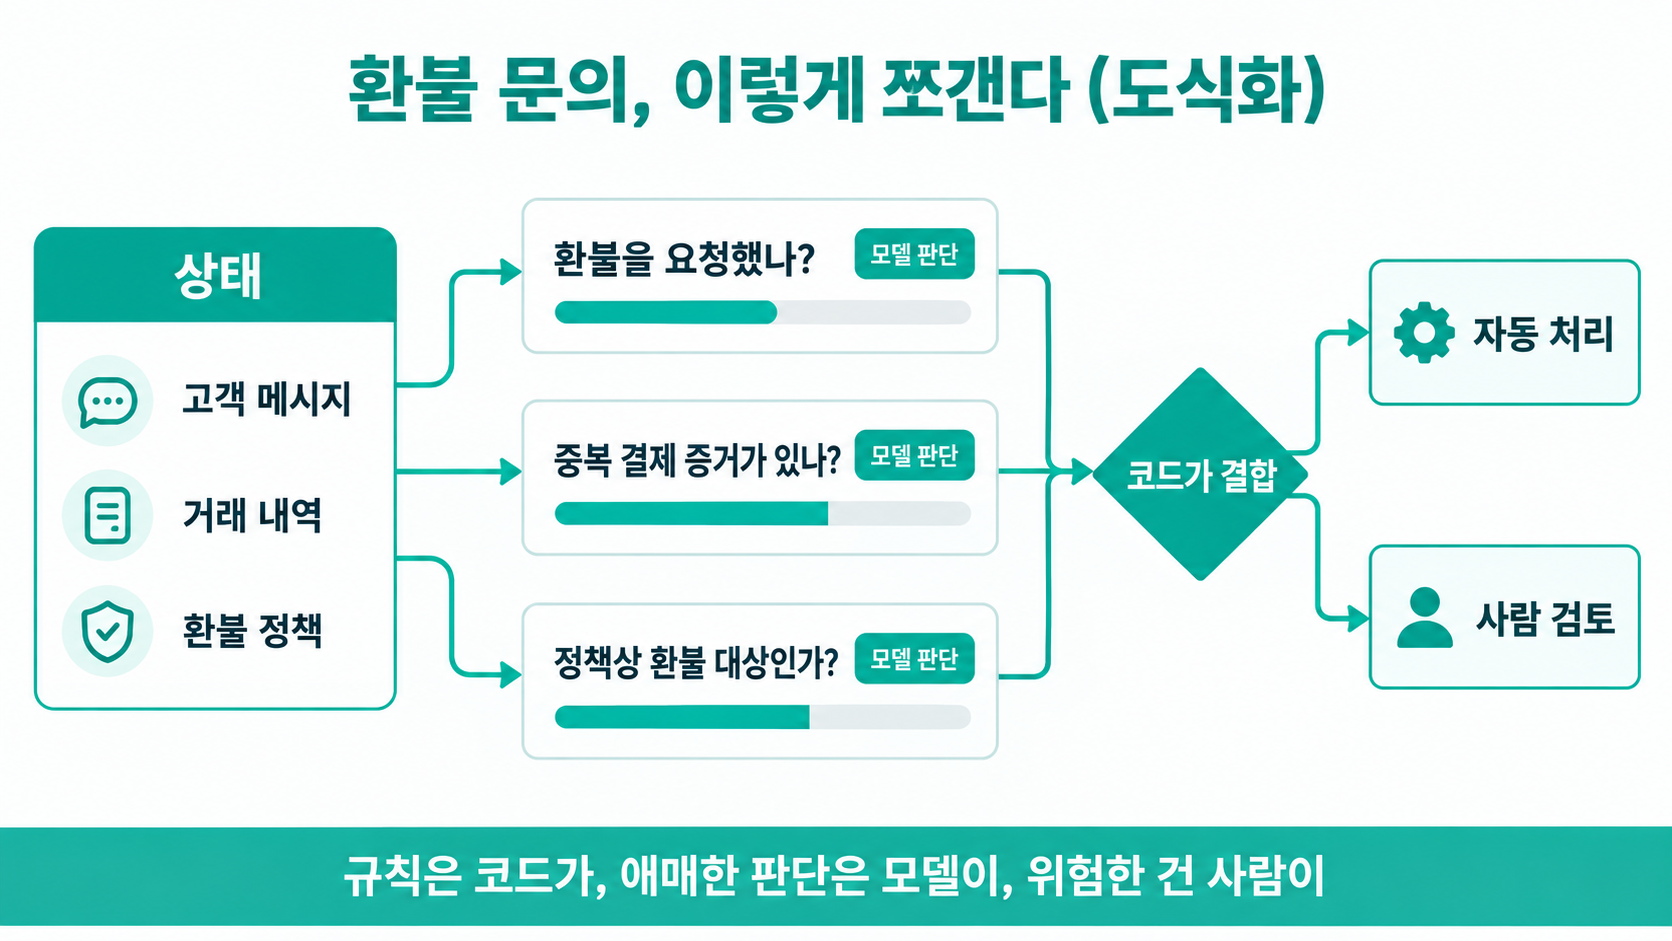
TypeSafe 문서에 나오는 환불 문의 사례로 보면 이렇다. 고객 메시지와 거래 내역, 환불 정책을 하나의 '상태(state)'로 묶어 넘기고, 미리 정한 질문을 함께 보낸다. 환불을 요청했는가, 중복 결제의 증거가 있는가, 정책상 환불 대상인가. Jev는 이 질문들을 한 번에 병렬로 평가해 답을 돌려준다. 실제로 환불을 해 줄지는 그 답을 받은 코드가 정한다.
질문 형식은 세 가지다. 목록에서 하나를 고르는 '초이스', 등급을 매기는 '스코어', 참일 확률을 내놓는 '눌(Noul)'이다. 문서에 따르면 초이스와 스코어는 보기별 확률 분포와 함께 그 분포에서 계산한 신뢰도(confidence)를 돌려주고, 눌은 참일 확률만 돌려준다. 알메이다는 해커뉴스 댓글에서 이를 프로그래머의 말로 풀었다. 초이스는 분기문(match), 스코어는 정렬, 눌은 if문에 대응한다는 것이다.
못 하는 일도 분명하다. 문서는 이 모델이 "답장을 쓰거나 코드를 만들거나 추론 과정을 설명하지 않는다"고 적었다. 알메이다는 해커뉴스에서 출력 형식으로 문자열과 순차적 자료구조는 아예 허용하지 않는다며, 그래야 모든 출력을 병렬로 계산할 수 있고 출력 요금도 받지 않을 수 있다고 설명했다. 입력으로는 텍스트나 구조화된 데이터를 받는다. "사실상 날것의 텍스트를 입력받는 제로샷 분류기"라는 한 사용자의 요약에는 "정확하다!"고 답했다. 제로샷 분류기는 해당 과제용으로 따로 학습시키지 않고, 보기만 주면 바로 분류하는 모델을 말한다.
아래 표의 가격과 응답 시간은 TypeSafe 블로그의 비교표에 실린 값이다. 회사가 나란히 적은 범위일 뿐, 같은 입력·출력 조건에서 일대일로 잰 값은 아니다.
| 대형언어모델(LLM) | Jev | |
|---|---|---|
| 내놓는 것 | 문장·코드 등 자유로운 텍스트 (구조화 출력 기능으로 정해진 형식도 가능) | 미리 정한 선택지·등급·참거짓과 그 확률 |
| 만드는 방식 | 출력 토큰을 하나씩 순서대로 | 모든 질문을 한 번에 병렬로 |
| 못 하는 것 | — | 글쓰기, 코드 생성, 이유 설명 |
| 가격 (회사 비교표) | 입력 100만 토큰당 $0.20~$10, 출력은 입력의 약 5배 | 입력 100만 토큰당 $0.042, 출력은 과금하지 않음 |
| 응답 시간 (회사 비교표) | 3~329초 | 0.07~0.5초 |
| 이용 방법 | 공개 서비스 | 대기자 명단 기반 얼리액세스 |
'444.6배 저렴'은 누구와 견준 숫자인가
TypeSafe 홈페이지 맨 위에는 "193.6배 빠르고, 444.6배 저렴하다"는 문구가 걸려 있다. 바로 아래에 'System One 업무 워크플로 기준'이라는 작은 표시와 근거 링크가 붙어 있고, 링크를 따라가면 블로그가 이 숫자가 자체 '워크플로 평가'에서 나왔다고 밝힌다. 평가 사이트에 공개된 원자료를 열어 보면 숫자의 조건이 보인다.
평가는 네 가지 업무로 이뤄졌다. 보안 경보 처리, AI 에이전트 실행 기록 점검, 송장 처리, 고객 상담이다. 업무마다 판단을 작은 질문들로 쪼개 여러 모델에 똑같이 풀게 했다. 채점 기준은 실제 정답이 아니다. OpenAI의 GPT-6 Astra와 앤트로픽의 Fable 5.1을 'high' 추론 설정으로 돌려 얻은 답의 평균이다. 그러니 여기서 '정확도'는 사람이 검증한 정답이 아니라, 두 대형 모델의 답으로 만든 기준에 견준 회사 자체 평가 점수다. 점수를 매긴 정확한 산식은 공개 페이지에서 찾지 못했다. 나머지 모델은 각 회사의 기본 추론 설정으로 돌렸다.
네 업무 평균은 다음과 같다. 평가 사이트의 표기값을 그대로 옮겼다(GPT-5.6의 Sol·Terra·Luna 등급은 OpenAI 모델이다).
| 모델 | 기준 답 대비 정확도 | 건당 비용 | 건당 시간 |
|---|---|---|---|
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3초 |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8초 |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1초 |
| Claude Sonnet 5 | 67.8% | $0.1174 | 78.1초 |
| Jev | 67.8% | $0.0004 | 0.4초 |
| GPT-5.6 Luna | 66.8% | $0.0033 | 12.9초 |
| DeepSeek V4 Pro | 65.5% | $0.0413 | 86.5초 |
| DeepSeek V4 Flash | 64.4% | $0.0059 | 51.9초 |
| Claude Haiku 4.5 | 53.6% | $0.0195 | 12.5초 |
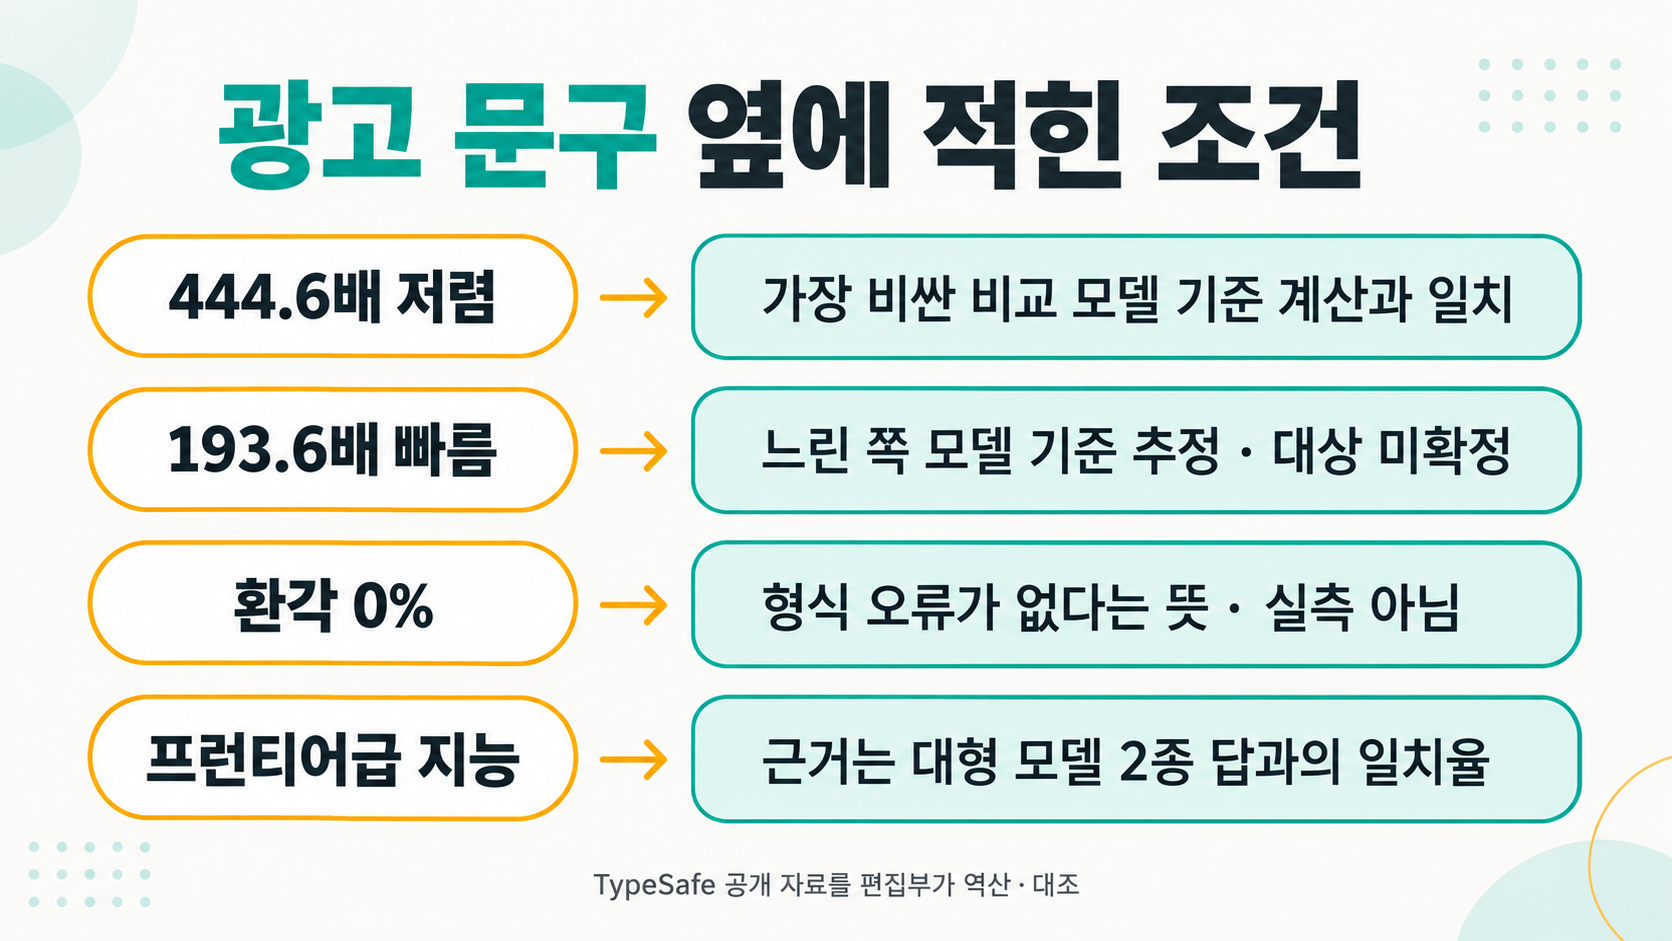
표시된 평균 점수로 보면 Jev는 GPT-5.6 Terra, Claude Sonnet 5와 비슷한 67%대다. 회사 자체 평가의 이 네 업무에서 Jev의 비용과 시간은 다른 모델보다 크게 낮게 측정됐다. 그렇다면 홈페이지의 배수는 누구와 견준 것일까. 표로 거꾸로 계산해 보면 실마리가 보인다. Opus 5의 $0.1761을 Jev의 $0.0004로 나누면 약 440배로, 반올림 전 값을 감안하면 '444.6배'와 들어맞는다. Opus 5는 이 표에서 가장 비싼 모델이다. 속도 쪽은 Sonnet 5의 78.1초를 0.4초로 나눈 약 195배가 '193.6배'와 가깝다. 다만 반올림된 표기값만으로는 속도의 비교 대상을 확정할 수 없다. 딥시크 V4 Pro의 86.5초로 계산해도 반올림 범위 안에 들어오기 때문이다.
점수가 비슷한 GPT-5.6 Terra와 비교하면 편집부 계산으로 약 25배 빠르고 비용은 약 76분의 1이다. 점수가 1%포인트 낮은 GPT-5.6 Luna와는 약 32배 빠르고 비용은 약 8분의 1이다. Jev의 시간과 비용이 각각 0.4초, $0.0004로 반올림돼 표기돼 있어, 표기 정밀도만으로도 실제 배수는 15% 안팎 달라질 수 있다. 점수가 비슷하다고 성능이 같다고 볼 수도 없다. 그래도 수십 배 차이는 크다. 다만 모든 경쟁 모델보다 비용이 400분의 1이라는 뜻은 아니다.
회사도 블로그에 단서를 달았다. 이 배수는 "실제로 얻을 이득 가운데 높은 쪽"일 것이라고 했다. 평가 업무는 자사 모델 역량팀 사람들이 만들어 "어느 정도 편향이 있을 수 있다"고 인정했다. 반대로 기준 답을 OpenAI와 앤트로픽 모델로 만들었으니 두 회사 모델에 유리한 쪽으로 기울 수 있다고도 적었다. LLM들은 TypeSafe가 만든 래퍼를 거쳐 구조화된 판단을 내게 했는데, 회사는 이 방식이 자신들이 찾은 가장 정확한 방법이지만 확률 없이 판단만 내게 하는 방식보다 느리고 비싸다고 설명했다. 응답 시간은 서비스가 있는 미국 서부에서 노트북으로 요청을 보내 잰 값이 대부분이라고 밝혔다. 가격에 대해서는 홈페이지 FAQ에서 "현재 가격으로도 수익을 내며 서비스할 수 있다"고 하면서도, 블로그에선 "보조금이 들어간 가격이 아님을 증명할 수는 없다"고 적었다. 수익성과 지속 가능성은 외부에서 확인된 바 없다. 배수 표기도 자료마다 다르다. 창업자 게시물은 '속도 20~200배, 비용 40~400배', 블로그 비교표는 '속도 40~200배', 보도자료는 '최대 100배 빠르고 저렴'이었다.
업무별로 쪼개 보면 편차도 크다. 고객 상담에선 Jev가 76.0%로 1위 Sol(78.3%)과 점수 차가 작았다. 반면 송장 처리에선 61.8%로 아홉 모델 중 8위였다(1위 Sol 79.1%). 이 점수 격차가 실제 송장 처리 오류와 손실로 얼마나 이어지는지는 따로 검증해야 한다. 다만 실수의 대가가 큰 업무일수록 건당 몇 센트의 비용 차이만 보고 고를 일은 아니다.
평가 방식을 두고는 양쪽 해석이 나온다. 개발자 블로거 숀 고데키는 "LLM이 JSON 덩어리를 한 토큰씩 불필요하게 만들어 내도록 강제하지 않는 비교"도 보고 싶다고 썼다. 비교 조건이 Jev에 유리했다는 지적이다. 한편 이 평가에서 눈여겨볼 결과도 있다. 사이트에 따르면 네 업무 평균에서 모든 모델이, 한 번에 통째로 시킬 때보다 질문을 쪼개 시킬 때 점수가 더 높았고 더 싸고 더 빨랐다. 서브스택 필자 앤서니 마이오의 말대로 "이 실험은 Jev를 옹호하기에 앞서 분해를 옹호한다."
'환각 0%'의 정체
블로그에는 모델별 '환각과 타입 안전성'을 비교하는 차트가 있고, 회사는 Jev 쪽에 0%를 넣었다. 그런데 바로 아래 단서는 이렇다. "우리 수치는 실측이 아니다. 스키마 일치가 보장되므로 0%를 자신 있게 넣었다." 미리 정한 선택지와 형식을 벗어난 답은 구조적으로 나올 수 없으니 형식 오류가 0이라는 뜻이다. 홈페이지는 같은 '환각 제로' 문구의 근거로 모든 판단에 신뢰도 추정이 붙어 확신이 낮으면 사람에게 넘길 수 있다는 점을 들었는데, 문서상 눌 질문에는 별도 신뢰도 값 없이 확률만 나온다.
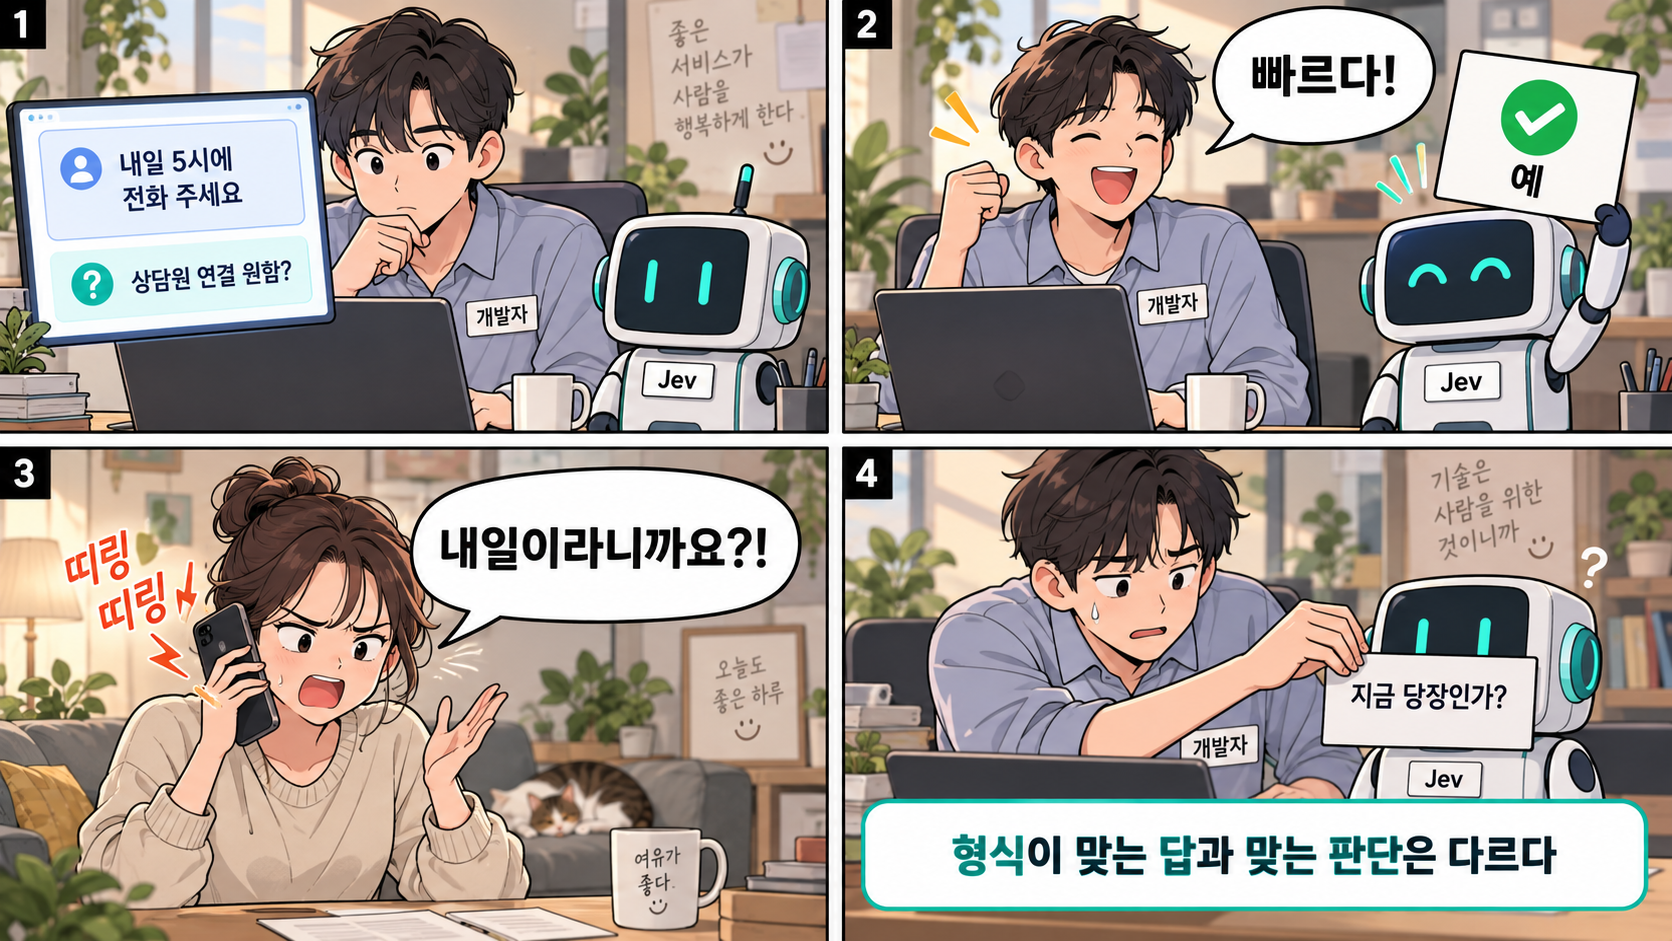
형식이 맞는다고 답이 맞는 것은 아니다. 해커뉴스 최상위 댓글이 이 점을 짚었다. "물론 잘못된 형식은 내놓지 못한다. 하지만 형식은 맞는데 완전히 틀린 값은 여전히 내놓을 수 있다." 알메이다도 부정하지 않았다. 그는 "이 모델들은 확률적이어서 자신 있게 틀리는 것도 가능하다"고 인정했다. 대신 "선형 분류기가 환각을 일으킨다고 말하겠는가?"라고 되물었다. 틀린 보기를 고르는 것은 모든 머신러닝 모델의 오류이지, LLM이 없는 사실을 지어내는 '환각'과는 다르다는 주장이다.
반론도 날카로웠다. 한 사용자는 발표문이 차트에 0%를 넣고는 그 근거를 스키마 보장으로 설명한다며 이렇게 반박했다. "허가되지 않은 행동을 '승인'한 답도 스키마 보장은 충족한다." 고데키는 '환각이 없다'는 주장을 말장난에 가까운 회피라고 봤고, 마이오는 "Jev가 제약하는 것은 출력의 모양이지 판단이 아니다"라고 정리했다.
그렇다면 Jev가 내놓는 확률은 얼마나 믿을 수 있을까. TypeSafe는 Jev가 보정(calibration)된 확률을 낸다고 강조한다. 어떤 답에 80%의 확률을 매긴 예측들을 모았을 때 실제로 약 80%가 맞으면 잘 보정됐다고 한다. 그런데 TypeSafe 문서 스스로 "보정은 여러 예측을 묶어서 측정하는 것이며, 개별 답이 옳다는 보장은 아니다"라고 적었다. 마이오는 보정 곡선도, 다른 사람이 재현할 수 있는 논문도 아직 공개되지 않았다고 지적했다.
실무 교훈은 두 가지로 모인다. 첫째, 질문과 보기를 설계하는 사람의 책임이 커진다. 정답이 보기에 없어도 모델은 주어진 보기들 사이에 확률을 나눠 줄 수밖에 없다. '모름'이나 '해당 없음' 같은 출구를 만들어 둬야 하는 이유다. 둘째, 신뢰도의 문턱은 위험에 따라 달라야 한다. TypeSafe 문서의 코드 예제도 그렇게 짰다. 신뢰도가 0.5 미만이면 사람에게 넘긴다. 잔액 조회는 잘못된 화면을 보여줘도 되돌릴 수 있는 낮은 위험으로 분류해 바로 처리한다. 송금 승인은 신뢰도가 0.9를 넘을 때만 확인을 거쳐 실행하고, 그보다 낮으면 사용자에게 다시 묻는다. 문서는 적절한 문턱이 업무와 모델 성능에 따라 다르니 보수적으로 시작해 자기 데이터로 조정하라고 덧붙였다. 이 숫자는 예제의 분기 기준일 뿐 안전성을 검증한 기준이 아니며, 신뢰도 값이 권한 확인이나 거래 규칙, 사용자 확인을 대신하지는 않는다.
정말 새로운가 — 기존 모델로 흉내 내려는 시도들
Jev가 하는 일 자체는 낯설지 않다. 문장을 분류해 확률을 내는 모델은 BERT 같은 인코더 모델 시절부터 있었고, 보기를 즉석에서 받아 분류하는 제로샷 모델도 여럿 나와 있다. 해커뉴스에선 그런 인코더를 누구나 쓰게 만든 것 아니냐는 댓글, 제로샷 정보 추출 모델 GLiNER에 알맞은 실행 틀을 붙인 것과 닮았다는 댓글이 달렸다. 자기 데이터가 충분하다면 XGBoost 같은 전통 모델을 학습시키는 편이 낫지 않냐는 질문도 나왔다. 특이점 갤러리에도 "Jev 저건 BERT하고 뭐가 다름?"이라는 글이 올라왔다.
고데키는 더 구체적으로 반박했다. 일반 LLM도 답의 앞부분을 미리 채워 두고 보기 가운데 토큰 하나만 고르게 하면, Jev가 내세우는 속도와 일관성, 병렬성의 대부분을 얻을 수 있다는 것이다. 그는 작은 오픈 모델(Qwen2.5-1.5B)로 직접 해 보니 앞부분을 채우지 않은 구조화 출력보다 2~3배 빨랐다며, Jev에 실질적인 기술적 해자는 없을 것 같다고 추정했다. 창업자의 X 게시물 약 8시간 뒤엔 한 개발자가 "그들은 2년 동안 스텔스로 만들었고, 나는 2시간 동안 스텔스로 만들었다"며 Qwen-2.5 1B 기반 모델을 공개했다. 타입 안전성이 필요한 JSON 작업에서 기기 안 추론이 5배 빠르다고 주장했지만, 비교 조건과 성능은 검증되지 않았다. 특이점 갤러리에도 LLM의 출력 확률을 보기 번호에만 맞춰 읽으면 비슷하게 흉내 낼 수 있다는 설명 글이 올라왔다. "추론 끄면 jev나 다름없음"이라는 별도의 회의적인 글에는 "속도 몇십배차이 + 가격몇십배차이 + 비추론은 오류율 높음"이라는 반박 댓글이 달렸다. 이런 시도들이 Jev의 학습 방식이나 성능을 재현했다는 뜻은 아니다.
그렇다고 쉽게 따라 할 수 있는 기술로만 보기도 어렵다. 고데키도 같은 글에서, 오픈 모델을 개조한 대부분의 시도보다는 Jev가 나을 것이라고 봤다. 구조화된 출력만을 겨냥해 모델을 미세조정하고 최적화할 수 있다는 점이 의미 있는 이점일 것이라는 이유에서다. 회사가 내세우는 새로움도 그 학습 방식에 있다. RLCD, 즉 확률이 실제 적중률과 맞아떨어지도록 훈련한다는 목표다. 알메이다는 X에서 이를 "제로샷 + 범용 = 프로그래밍 가능"이라고 요약했다. 과제마다 따로 학습시키지 않고 질문만 바꿔 여러 곳에 끼워 쓸 수 있다는 뜻이다.
문제는 그 핵심이 거의 공개되지 않았다는 점이다. 알메이다는 아키텍처를 당분간 공개하지 않겠다면서 논문을 쓰는 방안은 논의해 왔다고 했다. 학습 데이터에 대해 FAQ는 "모든 데이터를 직접 만든다"고 한 뒤 "더 알고 싶다면 우리가 당신을 채용해야 한다"고 답한다. 공개 벤치마크 성적은 "일부러 발표하지 않기로 했다"며, 사용자가 자기 업무로 직접 평가해 보라고 권한다.
회사가 창업자를 'RLHF의 공동 발명자'로 소개하는 대목도 짚어 둘 만하다. 알메이다가 ChatGPT의 직계 토대인 InstructGPT 논문(2022)의 공저자인 것은 사실이다. 다만 사람의 피드백으로 AI를 학습시키는 연구는 그 이전부터 이어져 왔고, InstructGPT 논문이 인간 피드백 강화학습(RLHF)의 대표 선행 연구로 인용하는 2017년 폴 크리스티아노 등의 논문에 알메이다는 저자로 참여하지 않았다. 공개 논문으로 확인되는 이력은 InstructGPT 공저이며, 'RLHF 공동 발명'은 회사의 소개 문구다.
커뮤니티 반응 — 비교 조건 논쟁과 실시간 활용 기대
같은 발표를 두고 커뮤니티마다 초점이 달랐다. 아래는 편집부가 수집한 제한된 표본에서 본 장면이다.
해커뉴스(영어권 표본)는 발표문의 표현부터 따졌다. 최상위 댓글은 새롭고 흥미로운 시도라고 축하하면서도, '범용 생성을 빠른 타입 추론과 맞바꾼 모델'이 더 정확한 제목이라고 했다. 실무 개발자의 기대도 컸다. 한 사용자는 "프롬프트와 평가를 한참 만지작거린 끝에, 나는 실제 서비스에서 LLM을 정확히 이렇게 쓰고 있다. 좁게 선택하게 하고 구조화된 데이터를 돌려받는 용도로"라며, 주장대로라면 에이전트 시스템의 새 표준이 될 것이라고 했다. 계약서에 특정 조항이 있는지 확인하기, 기사 1,000개 중 가장 관련 있는 5개 고르기 같은 쓰임새 아이디어도 여럿 나왔다. 알메이다는 이 스레드에만 답글 24개를 남기며 직접 질문에 답했다. 출시 전 접근권을 받았다는 한 초기 사용자는 이런 모델이 "LLM을 대체하기보다 함께 쓸 때 대단히 잘 작동한다"고 했고, 다른 초기 사용자는 문맥 창이 3만 2천 토큰으로 작다는 점을 아쉬움으로 꼽았다.
레딧 r/accelerate(영어권 표본)에선 더 기본적인 질문이 먼저 나왔다. "바보 같은 질문일 수 있지만, 텍스트를 안 내놓는다면 대체 뭘 할 수 있나?" "분류기?"라는 짧은 댓글도 달렸다. "근본적으로 다른 일을 하는데 'LLM보다 몇 배 싸다'는 말은 성립하지 않는다"는 지적에는 "그건 'ASIC이 GPU보다 몇 배 싸다는 건, 하는 일이 근본적으로 다르니 공정하지 않다'고 말하는 것과 같다"는 반박이 붙었다. 전용 칩이 범용 칩보다 싼 것처럼, 일을 좁히면 싸지는 것 자체가 가치라는 논리다.
특이점 갤러리(국내 표본)에는 발표 당일 아침부터 관련 글이 잇따랐다. 개념글에 오른 한 게시물은 "llm과는 성격이 다른 또 엄청난 무언가가 나온 것 같다 보고 머리가 띵해짐"이라고 적었다. 오전 10시쯤엔 "jev 이거 객관식 모델이라는거 같은데"라는 정리 글이 나왔고, 댓글엔 "럭키 자동응답기 아님?", "일단 광고는 좀 질소채워서 한거같음"이 이어졌다. 한 이용자는 "원래 ai 연구의 기본은 classification(예를 들어 개와 고양이 구분)로 부터 시작했음. 이 모델도 LLM을 분류 문제로 다시 회귀시킨 것 같은 느낌"이라고 짚었다.
저녁에는 게임 영상을 두고 감탄과 반론이 함께 나왔다. 게시자 설명에 따르면 Jev를 마인크래프트 봇에 연결했다는 유튜브 영상이 공유됐고(실제 Jev로 작동하는지는 확인되지 않았다), "멈춰서 생각하는 단계가 없으니 훨씬 사람 같은 모습"이라는 감탄이 나왔다. 뒤이어 올라온 "Jev 근들갑 아니라니까?"에는 "결국 움직이고 캐고 공격하는 등 로직은 다 짜놓아야" 한다는 반론 댓글과 함께, LLM이 "두뇌를 써서 생각하는" 쪽이라면 Jev는 "척수반사" 같다는 비유가 달렸다.
수집한 표본 안에서 눈에 띈 공통점도 있다. 해커뉴스의 초기 사용자가 'LLM과 함께 쓸 때'를 강조했듯, 특이점 갤러리에서도 "독자적으론 못쓰고 llm 비용 낮추는 툴로서는 유용할거라고 하던데", "부족했던 부분을 보완 가능하기 때문에 전체 시스템 구성 시 상당히 유용할 것 같다" 같은 반응이 나왔다. Jev를 LLM의 대체재가 아니라 시스템의 부품으로 보는 시각이다.
이름이 '제번스'인 이유 — 판단이 싸지면 생기는 일
Jev라는 이름은 19세기 영국 경제학자 윌리엄 스탠리 제번스에서 왔다. 제번스는 1865년 《석탄 문제》에서, 증기기관의 효율이 좋아지면 석탄 소비가 줄기는커녕 오히려 늘어난다고 지적했다. 효율이 좋아져 비용이 내려가면 수요가 늘어 총소비가 오히려 커질 수 있다는 '제번스의 역설'이다. TypeSafe는 블로그 FAQ에서 지능의 비용이 10분의 1로 떨어질 때마다 쓰임새는 그보다 훨씬 큰 폭으로 늘어난다고 적었다.
이 회사가 거는 판돈은 '더 똑똑한 챗봇'이 아니다. 지금까지 사람이 규칙을 일일이 코딩하거나 직접 판단하던 수많은 분기, 블로그의 표현으로는 '똑똑한 if문'을 싸고 빠른 AI 판단으로 채우는 것이다. 블로그의 둠 게임 시연에서 초당 10번 질의하는 데 든 비용은 시간당 약 7달러였다고 한다. 이 시연은 게임 화면 이미지가 아니라 텍스트로 표현한 구조화된 게임 상태를 입력으로 썼다. 비판적이던 고데키도 이 방향만큼은 반겼다. 그는 "빠른 구조화 출력은 지능을 다루는 진짜 새로운 계산 단위가 될 수 있다"고 썼다.
AI 자동화를 고민하는 독자라면 쓰임새를 이렇게 나눠 볼 수 있다. 편집부 정리이며, 한국어 성능은 아직 확인되지 않았다는 점을 전제로 한다.
- 시험해 볼 만한 후보: 문의 분류와 담당 부서 배정, 계약서·문서에 특정 조항이 있는지 확인, 커뮤니티 글의 1차 유해성 거르기, LLM이 쓴 답이나 인용이 원문과 맞는지 검사, AI 에이전트가 일을 제대로 끝냈는지나 같은 동작을 반복하는지 감시
- 맡기기 어려운 일: 글·코드·설명이 필요한 일, 긴 추론이 필요한 판단(회사도 복잡한 수학이나 체스 같은 계획 문제는 대형 추론 모델이 나을 수 있다고 밝혔다), 자기 데이터가 충분한 좁은 예측(전용 모델을 학습시키는 편이 나을 수 있다), 되돌릴 수 없는 결정을 사람 확인 없이 맡기는 일
다만 판단이 싸지면 판단의 횟수가 늘고, 같은 오류율이라도 전체 오류 건수는 늘어날 수 있다. 문턱을 잘못 잡은 시스템이라면 실수도 그만큼 대량으로 쌓인다는 것이 편집부의 우려다. 마이오도 개별 판단이 잘 보정돼 있어도 문턱과 가중치, 분기를 거친 전체 흐름까지 보정되는 것은 아니며, 서로 연관된 실수는 조합을 거쳐도 살아남는다고 경고했다. 확률만 내놓는 방식은 이유를 설명하지 않으므로, 이의 제기나 오류 추적이 필요한 시스템은 판단 근거를 따로 남겨야 한다는 점도 덧붙였다.
확인된 것과 아직 모르는 것
| 구분 | 내용 |
|---|---|
| 확인됨 | 9월 15일(미국 현지) 공개와 대기자 명단 기반 얼리액세스 / 입력 100만 토큰당 $0.042, 출력 무과금(회사 표기) / 질문 형식 3종(초이스·스코어·눌) / 워크플로 평가의 원자료와 조건(기준 답은 대형 모델 2종의 평균) / '환각 0%'가 실측이 아니라는 회사 스스로의 단서 / 창업자의 InstructGPT 논문 공저 |
| 회사 주장 (편집부가 확인한 자료에선 독립 검증을 찾지 못함) | 속도·비용 배수, 보정된 확률, 기존 LLM과 비슷한 수준의 지능, 현재 가격으로 수익을 낸다는 설명, 프롬프트 공격에 대한 취약점이 LLM과 다르다는 설명 |
| 아직 모름 | 아키텍처와 모델 크기, 학습 데이터 구성, 보정 곡선, 공개 벤치마크 성적(회사는 발표하지 않기로 함), 한국어 성능, 문맥 창 크기(초기 사용자는 3만 2천 토큰이라고 전함), 정식 출시 일정, 이미지 입력 지원(공개된 둠 시연은 화면 이미지 대신 구조화된 게임 상태를 썼고, 회사 표현은 "아직"), 홈페이지 속도 배수의 정확한 비교 대상 |
맺으며: 말하지 않는 AI가 던진 질문
Jev 공개 직후의 논쟁을 걷어 내면 두 가지가 남는다.
하나는 조건이 붙은 숫자들이다. '444.6배'는 비교군에서 가장 비싼 모델과 견준 계산과 부합했고, '환각 0%'는 실측이 아니라 형식 보장에서 나온 값이었다. 성능 점수의 기준도 사람이 검증한 정답이 아니라 대형 모델 두 종의 답이었다. 회사가 이 단서들을 블로그에 스스로 적어 둔 점은 평가할 만하다. 하지만 홈페이지 첫 줄에는 '워크플로 기준'이라는 짧은 표시와 링크뿐이어서, 비교 대상과 조건을 알려면 링크를 따라 들어가야 했다.
다른 하나는 질문이다. 최근 몇 년, 생성형 AI의 대중적인 얼굴은 대화였다. 무엇이든 말로 묻고 말로 답을 받았다. 그런데 소프트웨어 안에서 벌어지는 판단 가운데 상당수에는 긴 문장이 필요 없다. '예'인지 '아니오'인지, 그리고 얼마나 확실한지면 되는 경우가 많다. Jev가 정말 새로운 종류의 모델인지, 잘 포장한 분류기인지는 독립적인 검증이 나와야 가려질 것이다. 그래도 '모든 AI가 꼭 말을 해야 하는가'라는 물음은, Jev의 성패와 상관없이 AI를 일에 쓰려는 사람들이 한 번쯤 따져 볼 만하다.
※ 자료 확인 시점: TypeSafe 블로그·문서·평가 사이트·홈페이지 등 주요 자료는 2026-09-16 22:30 KST 무렵까지 확인했고, 일부 원문 대조는 23:20 무렵까지 이어졌다. 해커뉴스 점수·댓글 수는 21:40, 48시간 순위는 19:55 조회값이며, 디시인사이드 집계는 아래 명시한 게시 시각 범위 기준이다. 평가 수치는 TypeSafe 평가 사이트의 표기값(반올림)을 옮겼고, 홈페이지 배수와의 대조와 배수 범위는 편집부 계산이다. 성능은 모두 TypeSafe가 자체 측정한 것으로, 편집부가 확인한 자료에서는 독립 검증을 찾지 못했다. 블로그와 홈페이지의 FAQ는 접힌 항목을 펼쳐 원문을 확인했다. 창업자 X 게시물은 X의 공개 임베드 경로로 원문과 작성 시각을 직접 확인했으며, 임베드 텍스트가 링크에서 잘린 '40~400배' 뒤의 '저렴'은 이 게시물을 인용한 게시물로 확인했다. 신뢰도 0.5·0.9 문턱은 TypeSafe Confidence 문서의 코드 예제다. 문맥 창 3만 2천 토큰은 해커뉴스 초기 사용자의 전언으로 공식 문서에서는 확인하지 못했다. 재현 시도로 공개된 오픈 모델의 성능 주장도 검증되지 않았다. ※ 커뮤니티 인용: 해외는 해커뉴스 스레드(49717558)와 레딧 r/accelerate 스레드의 공개 댓글이다. 국내는 디시인사이드 특이점이 온다 갤러리를 자체 수집 도구로 조회했다. 9월 16일 01:46~21:44 KST 전체글 1,435건 가운데 제목이 정규식 `jev|제브|타입세이프|typesafe|system ?one|시스템 ?원|RLCD|알메이다|almeida`(대소문자 무시)에 걸린 글이 81건이었다. 제목만 셌기 때문에 본문에서만 언급한 글은 빠지고 농담 글은 포함됐다. 같은 시간대 챗GPT·AI 갤러리 전체글 193건에서는 0건이었다. 인용한 글 번호와 게시 시각은 다음과 같다: 1425251(08:42, 08:43 댓글), 1425332(09:58), 1425345(10:13, 10:14·10:18·11:12 댓글), 1426036(16:39, 16:40 댓글), 1426087(17:04), 1426343(19:28), 1426357(19:38, 19:40·19:42 댓글), 1426567(21:27). 따옴표 없는 대목은 요약이다. 모두 제한된 비확률 표본이므로 여론으로 일반화할 수 없다. ※ 본문 삽화는 AI로 생성한 개념 이미지다. 비교 인포그래픽과 흐름도는 TypeSafe 공개 자료를 도식화한 것이고, 4컷 만화는 해커뉴스 댓글(bigglebear, 49720851)에 나온 가상 사례를 재구성한 것으로 실제 사고 사례가 아니다.
출처
TypeSafe 원문
- 블로그 〈Introducing System One Models & Jev〉 · 홈페이지 · 팀 소개
- 기술 문서: System One · AI primer · Confidence
- 워크플로 평가 사이트
- 보도자료(Business Wire, Morningstar 게재)
- 디오고 알메이다: 발표 X 게시물 · X 답글 · 인용 게시물 Wall St Engine
창업자 이력 대조
외부 분석·재현 시도·보도
- Sean Goedecke, 〈Jev means structured output is interesting again〉
- Anthony Maio, 〈Jev: The Language Model That Won't Talk〉
- Harsha Gundala X 게시물(재현 모델 공개)
배경
커뮤니티
- 해커뉴스 49717558 · 댓글 jacobgold · lubujackson · thduabmd · bigglebear · latteren · ymir_e · bregmandiv · brainless · edot · 초기 사용자 tylermarques · 초기 사용자 nickstinemates
- 해커뉴스 알메이다 답글: 질문 유형 설명 · 제로샷 분류기 요약에 동의 · 확률적 오류 인정 · 선형 분류기 반문 · 아키텍처 비공개 · 문자열 불허
- 레딧 r/accelerate 스레드 · 댓글 pa1g3ny · pa1lk2z · pa2hj35 · pa2j562
- 디시인사이드 특이점이 온다 갤러리 · 마인크래프트 봇 영상(유튜브)